Vector Embedding과 FTS(Full Text Search) 차이부터 이해해보자.
우선 벡터 임베딩 개념부터 말씀드리자면
사람은 눈으로 이해하지만, 컴퓨터는 눈이 없는데요?
컴퓨터가 정보를 이해하기 위해서는 모두 bit(0과 1)로 변형되어야 한다.
벡터 임베딩 = 텍스트, 이미지, 오디오, 영상 같은 비정형 데이터를 [a, b, c, d, e, ...] 벡터화 한다.
임베딩은 뭔데?
벡터는 실수 Array고, 임베딩은 비정형 데이터를 실수 Array로 변환하는 것을 의미함.
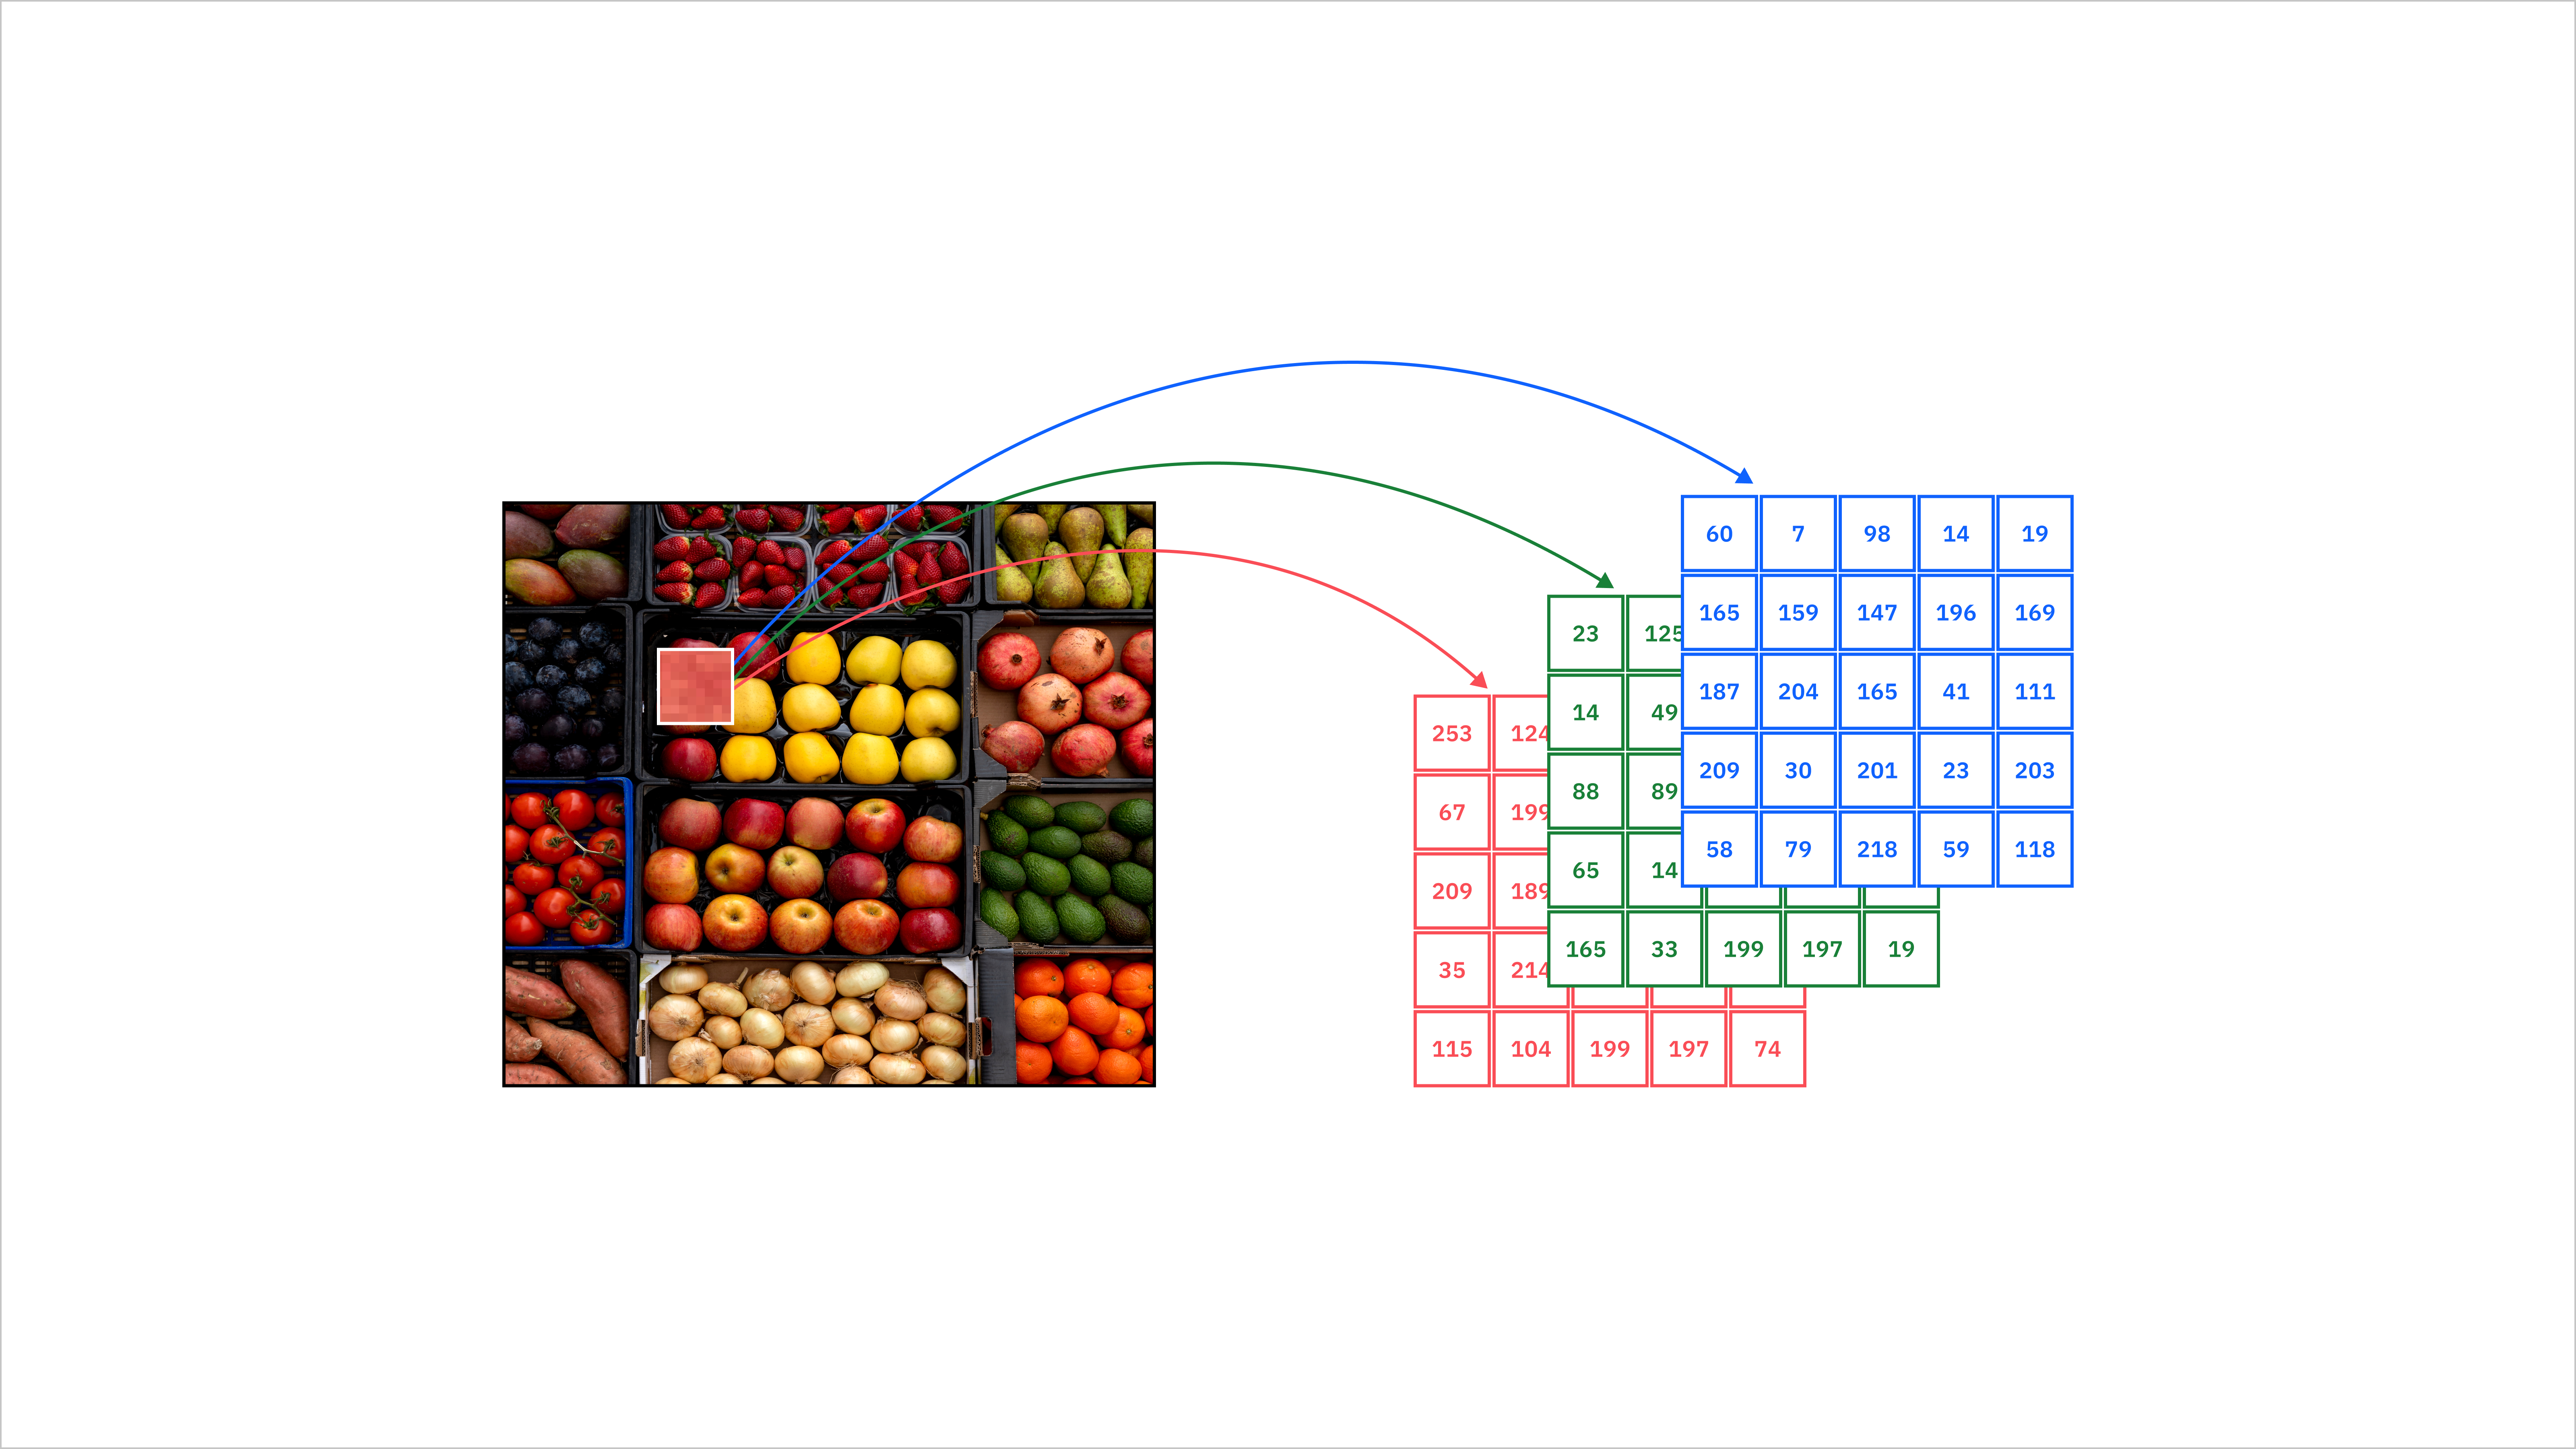
아래 과일 이미지 Raw 데이터 = 1px Dot는 RGB 값으로 이루어진 숫자 리스트이다.
RGB값을 기반으로 모니터에 출력된 이미지 = RGB 숫자 리스트.
이미지 = 숫자 리스트라는 의미.
학부 연구생 할 때 (2019년도) 석, 박사 행님들의 AI 세미나에서 줍줍했던 단어
"차원 축소" Dimension Reduction => 고차원의 데이터를 낮은 차원의 데이터로 '압축'하는 과정이다.
벡터 임베딩의 핵심은 '차원 축소'다. 이미지를 이루는 RGB 숫자 행렬(3 * 1920 * 1080 = 6,220,800 개의 숫자 값, 0~255 사이의)을 적절히 학습된 임베딩 모델(블랙 박스라고 생각하고)에 넣어서 뚝딱하면 => 1,024 개의 숫자(-1.0 ~ 1.0 실수 범위)의 리스트로 변환하면, 비슷한 이미지끼리 비슷한 공간에 매핑되는(?) 신기한 기술이다.
고차원의 정보량(6,220,800 개의 값)을 "잘 학습된 임베딩 모델"을 통해서 낮은 차원의 정보량(1,024개의 값, 이 때 1,024 차원으로 생각해도 좋음)으로 변환하는 것이다.
임베딩 했다치고, 이걸로 뭐 할 수 있는데요?
차원 줄이는것도 ㅇㅋ. 근데 줄여서 뭐할건데요?
고차원의 정보량이 차원 축소를 통해서 정보가 "압축"되면서 비슷한 성질을 띄는 데이터는 가까운 곳에 위치하게 되는 성질을 이용한다. 그래서 언제 쓰느냐.
(x) 정확한 값을 찾을 때 => SQL, 패턴 매칭 쓰시오
(x) 특정 단어가 들어간 문서 찾기 => BM25 쓰시오. 빠르고 저렴하오
(o) A를 input으로 할 때, A` A`` 즉, A와 비슷한 데이터를 찾을 때 쓴다
그러니께, 다시 이미지로 생각해보자
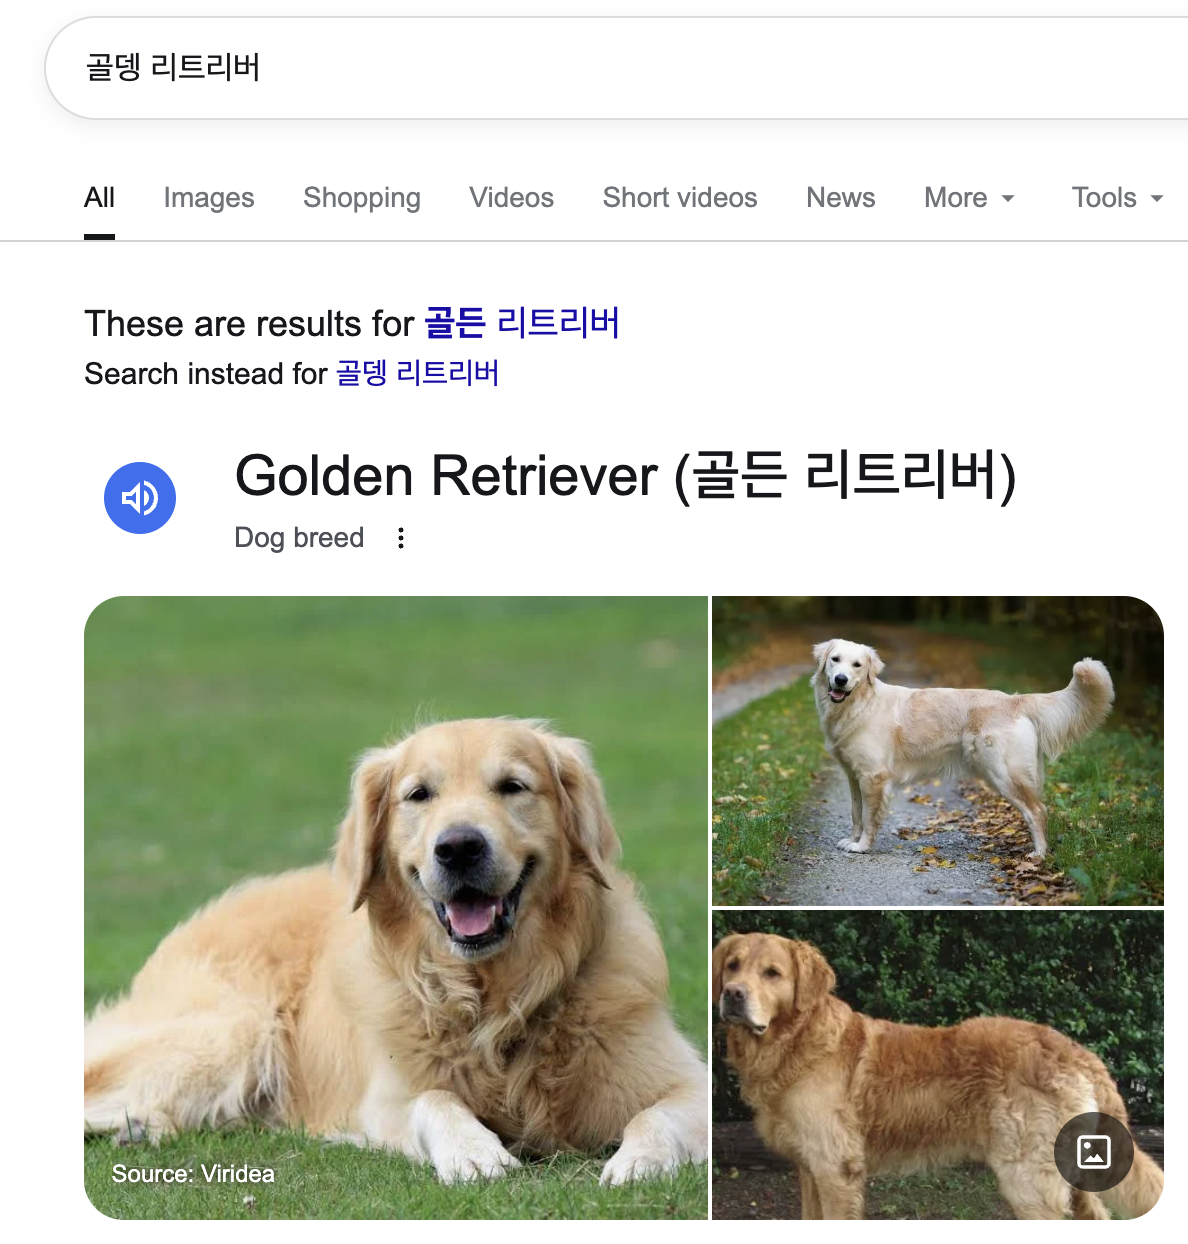
아래 골든 리트리버(챱츄)를 다양한 이미지에서 찾을 때 어떻게 찾을거냐는거죠
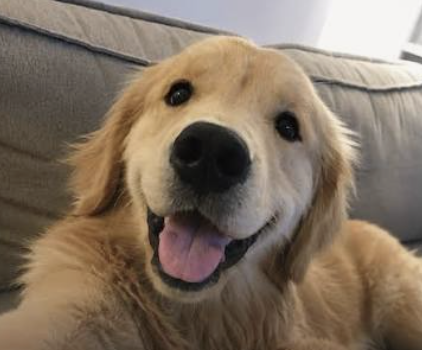
(1) 비슷한 색상을 찾나? -> 불가능
(2) 비슷한 모양을 찾나? -> 불가능
CV(Computer Vision)이라는 분야도 있다.
컴퓨터가 숫자로 이루어진 데이터를 '사람의 눈 처럼' 이해하도록 만들기 위해 다양한 알고리즘을 개발하는 분야다.
이 분야의 기술이 막힌 부분이 개랑 고양이 구분하는 알고리즘이다.(라고 들었음 교수님한테)
구분하도록 만들수는 있는데, '개 vs 고양이' 판별 전용 프로그램을 매번 만들어야한다.
개 vs 새 구분 프로그램이 필요하면, 이전에 만든 로직을 활용하기가 어렵거나, 불가능하거나, 가능할수도 있거나. 랜덤하다는 것.
근데 벡터 임베딩을 쓰면?
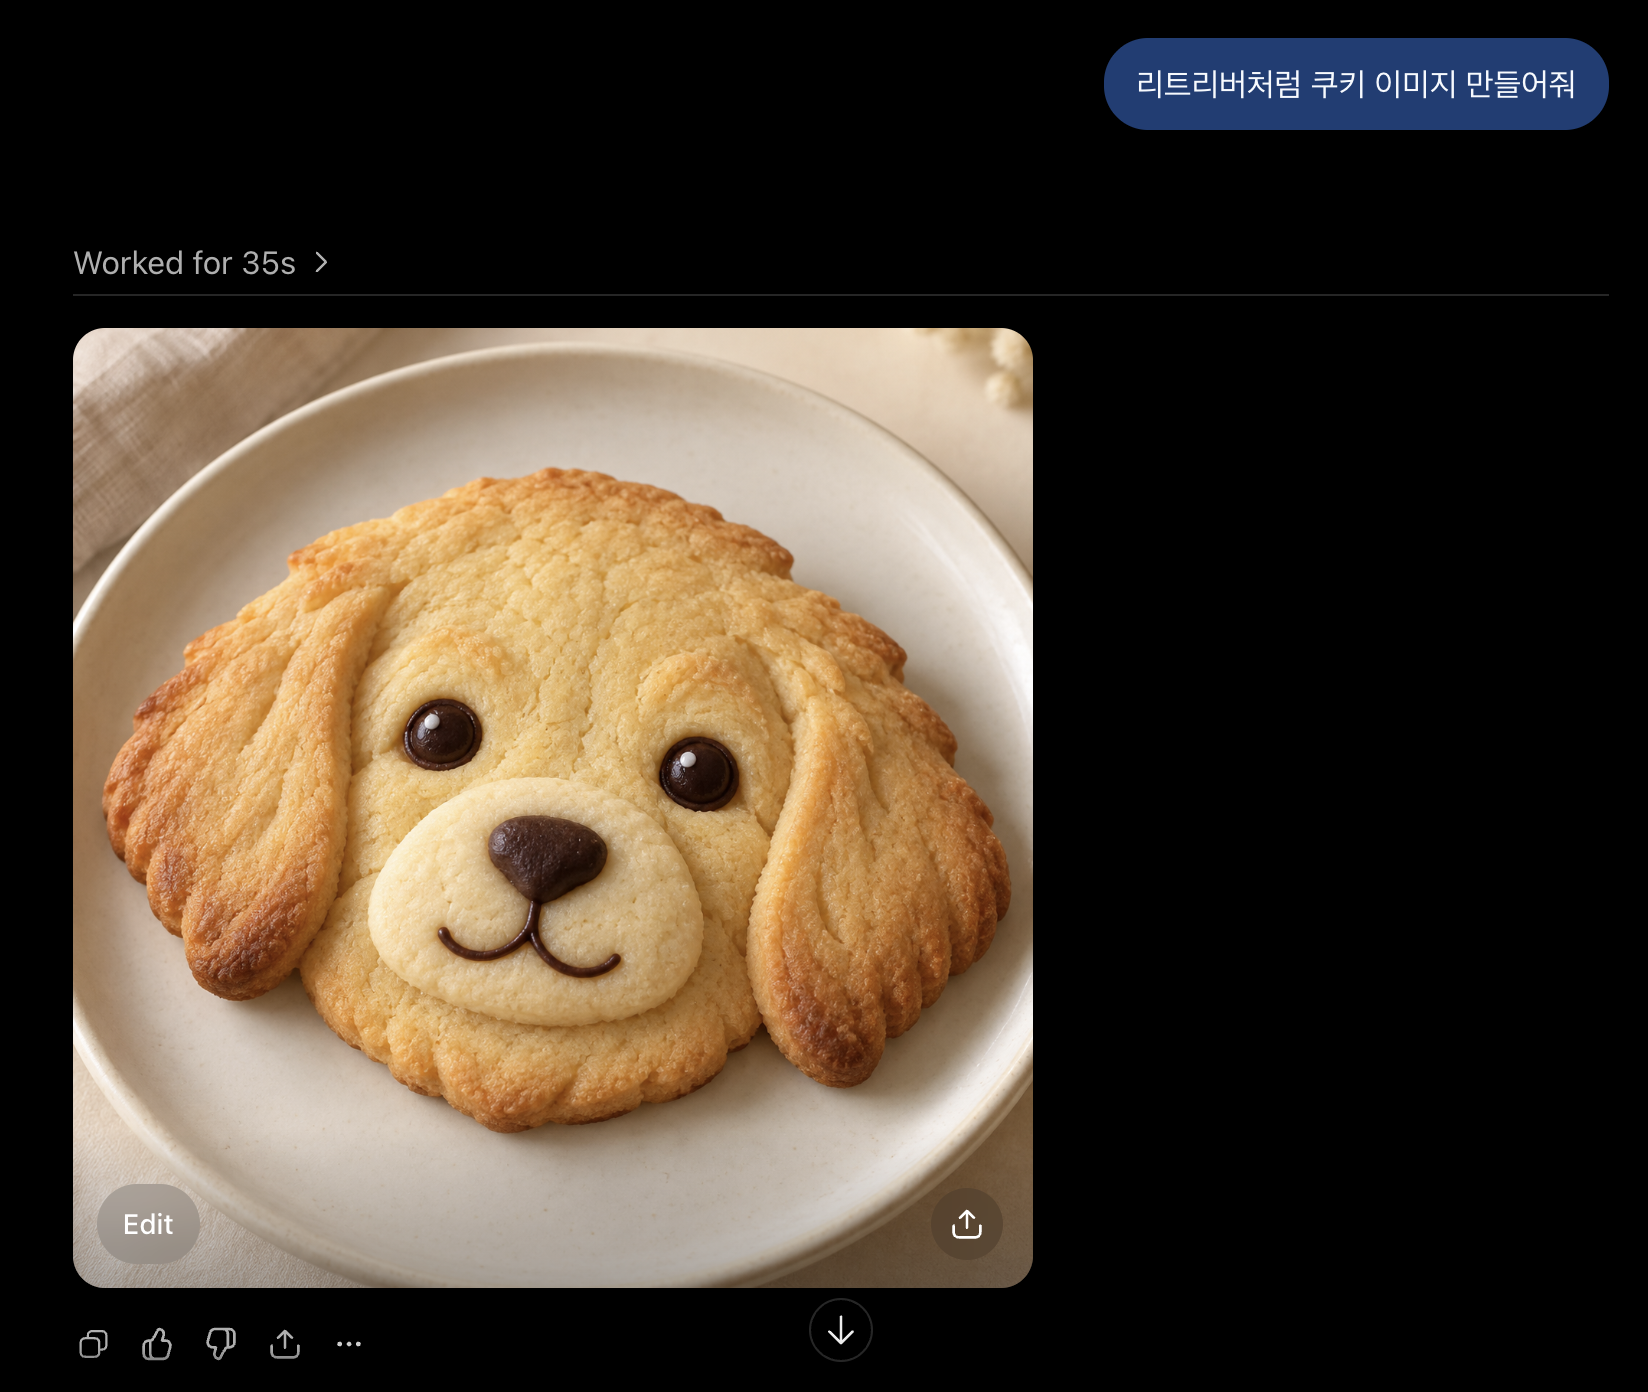
고차원의 데이터가 압축되면서 비슷한 성질을 가진 정보가 가까운 공간에 위치하게 된다는 것. (이게 어떻게 되는거냐 라고 물어보면 임베딩 모델을 '학습'시킬 때 의미 기반의 공간이 되도록, 데이터와 정답지를 미리 주고 모델을 혹사시키면 짜잔! 된다고 함. 대조학습으로 주로 훈련을 하기 때문에, 부정어를 넣으면 이해하지 못함. 왜냐, input data와 기존 데이터가 '관련'있는지를 중심으로 학습되기 때문에. 리트리버를 찾지마, No 골든 리트리버 이따위로 넣으면 골든리트리버 이미지가 나올것이다 : > )
여기까지 벡터 임베딩
FTS, tsvector, tsquery가 뭐임?
TS = Text Search.
FTS = Full Text Search = 전문 검색, 전사 검색이라고도 불림
그게 뭔데?
문서에서 '단어', '문장'을 찾아주는 기술임
검색 엔진이라고도 불리는데
이 검색 엔진도 맞는데 이거 말고
(1) 검색엔진 = 진짜 네이버, 구글 검색엔진을 의미
(2) 방대한 데이터에서 내가 찾으려는 '단어', '문장'의 조각을 "연관성 점수로 정렬해서" 찾는 기술
FTS 대표적인 기술, 엔진, 라이브러리 4종류
한번 쯤 들어보셨을
1. Elastic Search(전문적인 검색 엔진)
2. Mellisearch (최근에 나온 경량화 검색 엔진)
3. Postgresql 이 제공하는 FTS(RDBMS에 내장된 기능)
4. RediSearch (Redis에 붙은 인메모리 기반의 NoSQL FTS 기술)
FTS 핵심 기능 3가지
FTS가 되기 위해서는 3가지 코어 기능을 제공해야한다.
1. 텍스트 분석
텍스트를 쪼개고, 불용어(Stopword - NLP에서 쓰는 단어, 의미에 영향을 주지 않는 친구들을 제거하는것), 공통화(jumping, jumps, jumped, jump -> jump 1개로 일원화)
2. 역색인
Inverted Index 기술. 문장의 텍스트를 분석하고 -> 각 텍스트가 어떤 문서, 어디 위치에 있는지를 기록한다.
문서1
나는 기린이 좋다.
문서2
나는 귀여운 고양이가 좋다.
[Inverted Index]
나는: 문서1-0, 문서2-0
기린: 문서1-1
좋다: 문서1-2
귀여운: 문서 2-1
고양이: 문서 2-2
3. 랭킹 알고리즘
단어의 등장 빈도 및 밀도를 기준으로 '연관성'이 높다고 판단하고, 이를 수치화해서 제공해준다.
Vector Embedding vs FTS - 언제 어떤 기술을 사용할 것 인가?
키워드, 단어 중심의 검색이 필요하다 -> FTS = Full 전체 텍스트에서 찾으려는 아이를 발견하는 것
의미(문맥) 중심의 검색이 필요하다 -> Embedding = Vector base 검색이 필요한 것
query1: '시원한 여름 과일', 원하는 답변: '수박'
FTS: 수박 못찾음. 정확한 단어 매칭이 안 됨
Vector: 쌉가능. 왜? 비슷한 의미를 찾으니까
query2: 'Mac Book Air M2 13인치 16GB 스펙은?', 원하는 답변: "해당 모델의 제품 스펙"
FTS: "정확히 해당 기기의 모델 스펙을 찾아줄 수 있음
Vector: 비슷한 모델, 기기로 오해 가능. Mac Book Pro M2 16인치 16GB 제품의 스펙을 가져올 수도 있음.
정리.
FTS 쓰는 경우
1. 정확한 명사, 코드, 규칙, 규격에 대한 검색이 중요한 경우에는
2. AI 도입 부담. 단순 블로그, 단순 게시판, 단순 검색 결과에 명확히 포함된 것만 보여줘도 되는. ㅕㅇ우
Vector 쓰는 경우
1. LLM 기반의 AI 서비스(RAG로 확장): '우리 회사 휴가 규정 알려줘' => 사내 문서중 필요, 관련된 문맥을 통해 검색가능
2. 동의어, 유의어 등 질문의 의도 파악이 중요한 경우 => 배 아플 때 먹는 약 추천 => 의미기반 소화제, 진통제가 나와야 함
3. 다국어 검색: Delicious Apple => 맛있는 사과를 찾아줘야함
4. 추천 시스템